Motivasjon
Moderne sjakkbotter som Stockfish er umulige å slå. De spiller med en presisjon som overgår selv verdens beste spillere, denne styrken kommer med en bieffekt: trekkene er ofte umenneskelige. Sjakkprofiler har lenge kommentert hvordan Stockfish rutinemessig spiller trekk som ingen menneske ville vurdert, ofrer materiale uten åpenbar grunn, manøvrerer brikker til tilsynelatende passive ruter, og gjennomfører planer som bare gir mening mange trekk senere. Det er sjakk som er korrekt, men ikke intuitivt.
Dette vekket en tanke: hva om man i stedet for å optimere for ren styrke, prøvde å lage en bot som spiller som et menneske? Ikke basert på statistikk og kalkuleringer mange trekk i dybden, men på de trekkene som faktisk virker fristende, og de naturlige, aggressive, og vakre trekkene som menneskelige spillere trekkes mot. En slik bot ville ikke nødvendigvis vinne mot Stockfish, men den ville kanskje spille sjakk som er mer gjenkjennelig, mer underholdende, og mer lærerik å spille mot. Det er denne idéen som ligger til grunn for prosjektet: å trene en språkmodell på partier fra sterke menneskelige spillere, og se om den kan lære seg det menneskelige blikket for sjakk.
Konfigurasjon
Dataene
Dataene kommer fra lichess sin database over partier, her kan du laste ned 7 milliarder partier som de har registrert siden 2013. Jeg lastet ned omtrent 300 000 partier hvor begge spillerene har over 2000 i lichess rating, dette gjorde jeg sånn at trekkene forhåpentligvis er av god kvalitet.
Tokenisering av dataene
For at modellen skal kunne spille sjakk må den på et vis kunne forstå sjakkposisjonen, og det innebærer at vi gir den informasjon. Dette gjøres ved at vi må ta et parti, gjøre det om til tokens, gi det til modellen, også svarer den med tokens som på en eller annen måte skal tilsvare et sjakktrekk.
Når det kommer til å gjøre en posisjon om til tokens er det hovedsakelig to måter dette kan gjøres på. Nummer 1 er å ta sekvensen med trekk som har vært spilt, (f.eks. e4, e5, Nf3, Nc6 ...), også gjøre dette om til tokens. Nummer 2 er å ta alle brikkene i en posisjon (f.eks. R a1, N b1, B c1 ...), dette er tilsvarende å beskrive hvordan posisjonen ser ut. Dette gjør at modellen ikke har noen måte å vite hva som har skjedd tidligere i partiet, den betrakter bare sånn stillingen er akkurat nå.
Jeg valgte nummer 2 fordi jeg ønsket at modellen faktisk skulle trene på å ta posisjonen i betraktning, og deretter finne et bra trekk. Tross alt er dette mer likt hvordan et menneske spiller, hvis jeg hadde plassert Magnus Carlsen foran en sjakkstilling han aldri har sett før, hadde ikke han hatt noe problem med å finne et bra trekk å spille, selv om han ikke vet akkurat de trekkene som ble spilt for å havne i den stillingen.
I motsetning til dagens språkmodeller (eks. chatgpt) valgte jeg å lage tokenizeren for hånd. Dagens tokenizere er trent på BPE, som finner et system for å dele opp ord i tokens, men siden sjakk har helt bestemte regler og jeg kan beskrive sjakk på en presis måte, enkelt, valgte jeg å lage tokenizeren for hånd.
Dette vil si at jeg designer hvordan en gitt stilling skal gjøres om til tokens, da kan jeg velge hva som er relevant å ha med og hva som ikke er relevant.
Først må jeg kunne beskrive hvilke brikker er på brettet, og hvor brikkene er plassert.
Jeg valgte å scanne brettet fra venstre til høyre, øverst til nederst, også lage 2 tokens hver gang jeg finner en brikke. Token #1 sier hvilken brikke er det, token #2 sier hvilken rute brikken er på. Jeg kan for eksempel si at det er en svart bonde på c4 ved å gi p og c4.
Her ser du hvordan en stilling gjøres om til tokens. Jeg har valgt å bruke bokstaver for å beskrive brikker, for eksempel er hvit dronning Q og svart dronning q, dette er standard i sjakk.
Rutene beskrives som forventet: a1 er nederst i venstre hjørne for hvit, osv.
Det er ikke nok for språkmodellen å kun vite hvor brikkene er, vi må gi den mer informasjon. For eksempel må modellen vite hvem sin tur det er. Derfor valgte jeg å ha med en del "spesielle" tokens som jeg plasserer etter at jeg har beskrevet stillingen, og det er disse:
| Informasjon | Representasjon |
|---|---|
| Hvem sin tur er det? | w-move b-move |
| Hvem kan rokere? | C-K C-Q C-k C-q |
| Hvor kan man ta En Passant? | ep |
I tillegg har jeg med tokens for promotering =Q =R =B =N. Og noen tokens for å dele opp informasjonen. Dette er fordi det er lurt å ha et skille mellom tokens som representerer brettet og resten av informasjonen.
Totalt har vi disse tokenene å jobbe med
| Kategori | Tokens | Antall |
|---|---|---|
| Ruter | a1 a2 a3 a4 a5 a6 a7 a8 b1 ... |
64 |
| Brikker | K Q R B N P k q r b n p |
12 |
| Hvem sin tur? | w-move b-move |
2 |
| Hvem kan rokere? | C-K C-Q C-k C-q |
4 |
| En passant | ep |
1 |
| Promotering | =Q =R =B =N |
4 |
| Struktur | [BOS] [EOS] [PAD] [SEP] |
4 |
Totalt 91 ulike tokens.
Vi må også ha tokens for som modellen kan bruke for å angi et trekk, men dette trenger ikke være egne tokens. Vi kan bruke de vi allerede har. Jeg valgte at modellen skal alltid svare med enten 2 eller 3 tokens:
| Token | Beskrivelse | Eksempel |
|---|---|---|
| 1 | Hvilken rute står brikken på? | c7 |
| 2 | Hvilken rute den skal flyttes til? | c5 |
| 3 | Promotering (valgfri) | =Q |
Nå har vi designet et språk vi kan bruke for å kommunisere med språkmodellen på.
Etter at jeg har lagd et system for å gjøre en gitt stilling om til tokens gikk jeg gjennom alle partiene jeg har lastet ned fra lichess, og gjør alle partiene om til tokens før jeg i det hele tatt begynner å trene. Dette er imot konvensjon, det vanligste er å gjøre dette "i farta", samtidig som man trener modellen.
Etter å ha gjort alle stillingene i alle partiene om til tokens endte jeg opp med 22,5 millioner stillinger. Siden mange spillere spiller like åpninger vil mange av de være like, her vurderte jeg å fjerne duplikate stillinger, men på den andre siden bør modellen være god på populære åpninger, så "favorisering" av de populære åpningene tenkte jeg kan være en god ting.
Kontekstvindu
Når vokabularet er på plass må vi bestemme kontekstvindu.
Kontekstvinduet definerer hvor mange tokens modellen kan ta inn på én gang. Dette er ikke det samme som antall unike tokens i vokabularet. Vokabularet sier noe om hvilke tokens som finnes, mens kontekstvinduet sier noe om hvor lang en enkelt inputsekvens kan være.
For å bestemme riktig størrelse må man tenke på worst-case: hvor mange tokens trenger man for å beskrive en sjakkposisjon? I starten av et parti er alle 32 brikkene på brettet. Siden hver brikke beskrives med 2 tokens (brikke + rute), gir det 64 tokens bare for brikkene. I tillegg kommer tokens for tur, rokade og en passant. Hvis alle brikkene fortsatt er på brettet og man kan ta en-passant på en rute får man totalt 76 tokens, dette er maks antall tokens man kan få.
Kontekstvinduet ble derfor satt til 128. Dette er den minste potensen av 2 som er større enn worst-case inputlengden, og transformere fungerer gjerne best med kontekstvinduer som er potenser av 2.
Encoder eller Decoder
En transformer kommer i to varianter som er relevante her: encoder og decoder. Forskjellen ligger i hvordan de behandler informasjon.
En encoder ser på hele inputsekvensen på én gang. Hvert token kan fritt se på alle andre tokens, noe som gjør den god på å bygge opp en helhetlig forståelse av en gitt posisjon. Den leser hele brettet, danner seg et komplett bilde, deretter gir hele svaret uten noe mer "tenking".
En decoder, derimot, er autoregresiv. Det vil si at den genererer tokens ett om gangen, og hvert token kan bare se på de foregående tokenene. Dette er måten ChatGPT og de fleste moderne språkmodeller fungerer på, og det er den naturlige arkitekturen når man skal generere lange sekvenser.
For dette prosjektet valgte jeg en encoder, og valget virket naturlig: inputen er en komplett sjakkposisjon, og outputen er kort, bare 2 eller 3 tokens. Det er ingen grunn til å generere en lang sekvens steg for steg, og encoderens evne til å bygge en dyp, toveis forståelse av posisjonen virket som en fordel.
I ettertid er jeg likevel ikke sikker på at det var det riktige valget. En decoder-arkitektur ville latt modellen generere trekk-tokens autoregressivt, der hvert token betinges av det forrige. Først hvilken rute brikken står på, deretter hvilken rute den skal til. Dette speiler den faktiske strukturen i outputen, og det hadde sannsynligvis gjort håndteringen av den valgfrie promoteringtoken mye ryddigere, og kanskje unngått promoteringsbuggen beskrevet tidligere.
Dekoderen virker ved å ta tokenet den nettop genererte og legge det til inputet før neste steg. Dersom jeg for eksempel hadde gitt en språkmodell tokenene som tilsvarer Kongen var, ville den kanskje gitt gammel, snill, ond, eller lignende.
Deretter, for å generere neste ord setter språkmodellen den opprinnelige setningen (Kongen var), etterfulgt av det som ble generert (gammel), så det blir Kongen var gammel inn i transformeren. Deretter gjentas denne prosessen på nytt og nytt igjen.
Her kan du se stegene for en autoregresiv token generering i sjakk.
I sjakk er dette relevant fordi destinasjonsruten (token #2) logisk sett avhenger av hvilken brikke som flyttes (token #1). En encoder behandler alle output-tokens uavhengig av hverandre, mens en decoder ville fanget opp denne avhengigheten eksplisitt.
Evaluering
Første test
Etter første epoch, når modellen har trent på 22.5 millioner sjakkposisjoner, bestemte jeg meg for å teste modellen før jeg fortsatte på epoch 2. Jeg spilte som hvit og startet med trekket e4, her er svaret jeg fikk:
Som svar på e4 spilte modellen det fantastiske trekket c5=Q, den flytter bonden på c7 frem to ruter og promoterer den til dronning.
Hvorfor skjedde dette?
Problemet ligger i output-formatet. Et trekk består av maks 3 tokens: fra-rute, til-rute, og eventuelt en promoteringtoken. Derfor valgte jeg å begrense modellen til 3 tokens, men jeg hadde ikke definert noen token for "ingen promotering". Det betyr at modellen er tvunget til å finne på noe, derfor velger den det som er minst feil, nemlig =Q.
Løsningen er enkel i ettertid: enten innføre en dedikert token som eksplisitt betyr "ingen promotering".
Siden jeg allerede hadde satt inn såpass mye tid på treningen valgte jeg å ignorere promoteringer frem til det faktisk er lovlig å promotere.
Bot vs åpningsteori
For å teste hvor godt sjakkboten presterer i åpningsspill, brukte jeg Lichess sin åpningsutforsker som referanse. Dette verktøyet samler data fra millioner av partier og viser hvilke trekk som spilles oftest i åpningsposisjoner.
Fremgangsmåten var enkel: Hvit spiller som åpningsutforskeren, og spiller alltid det mest spilte trekket. Jeg noterte deretter hvor høyt boten sitt svartrekk rangerte i åpningsutforskeren. Hvis boten for eksempel svarte med det nest mest populære trekket, fikk den rangering 2.
Her er runden
Her er trekkene som ble spilt
| Trekk | Hvit | Svart | Rangert |
|---|---|---|---|
| 1 | e4 | c5 | 1 |
| 2 | Nf3 | d6 | 1 |
| 3 | d4 | cxd4 | 1 |
| 4 | Nxd4 | Nf6 | 1 |
| 5 | Nc3 | a6 | 1 |
| 6 | Be3 | e5 | 1 |
| 7 | Nb3 | Be6 | 1 |
| 8 | f3 | Be7 | 2 |
| 9 | Qd2 | O-O | 1 |
| 10 | O-O-O | Nbd7 | 1 |
| 11 | g4 | Qc8 | - |
Som du ser spilte språkmodellen det mest spilte trekket helt frem til trekk 8, hvor den spilte Be7 som er det nest mest spilte trekket i stedet for det mest spilte trekket: h5. forskjellen er likevel liten, h5 har 9 700 registrerte partier i åpningsutforskeren, og Be7 har 8 000.
Etter trekk 10 spiller åpningsutforskeren g4, og da svarer modellen med Qc8. Her var det mest spilte trekket egentlig b5, og nest mest spilt Qc7. Analyse sier at Qc8 er en tabbe, så nå regnes åpningsspillet som ferdig.
Totalt sett viste testen at språkmodellen presterer imponerende i åpningsspillet. De ti første trekkene var rangert som nummer 1 eller 2 i åpningsutforskeren, og det eneste avviket var marginalt. Dette tyder på at modellen har blitt veldig dyktig på åpninger.
Chess.com gir åpningen til språkmodellen 96,2% i nøyaktighet, som er imponerende. Spiller i verdensklassen pleier å ligge på dette nivået når det gjelder åpningsspill.
Bot vs stockfish nivå 3
For å få et inntrykk av hvordan modellen presterer i et fullt parti lot jeg den spille som svart mot Stockfish nivå 3. Stockfish nivå 3 er et relativt lavt nivå, og er derfor et rimelig utgangspunkt for en første test.
Her ser du partiet
Botten spiller relativt bra frem til trekk 16, og etter stockfish har flyttet for 17. gang spiller språkmodellen gxf6.
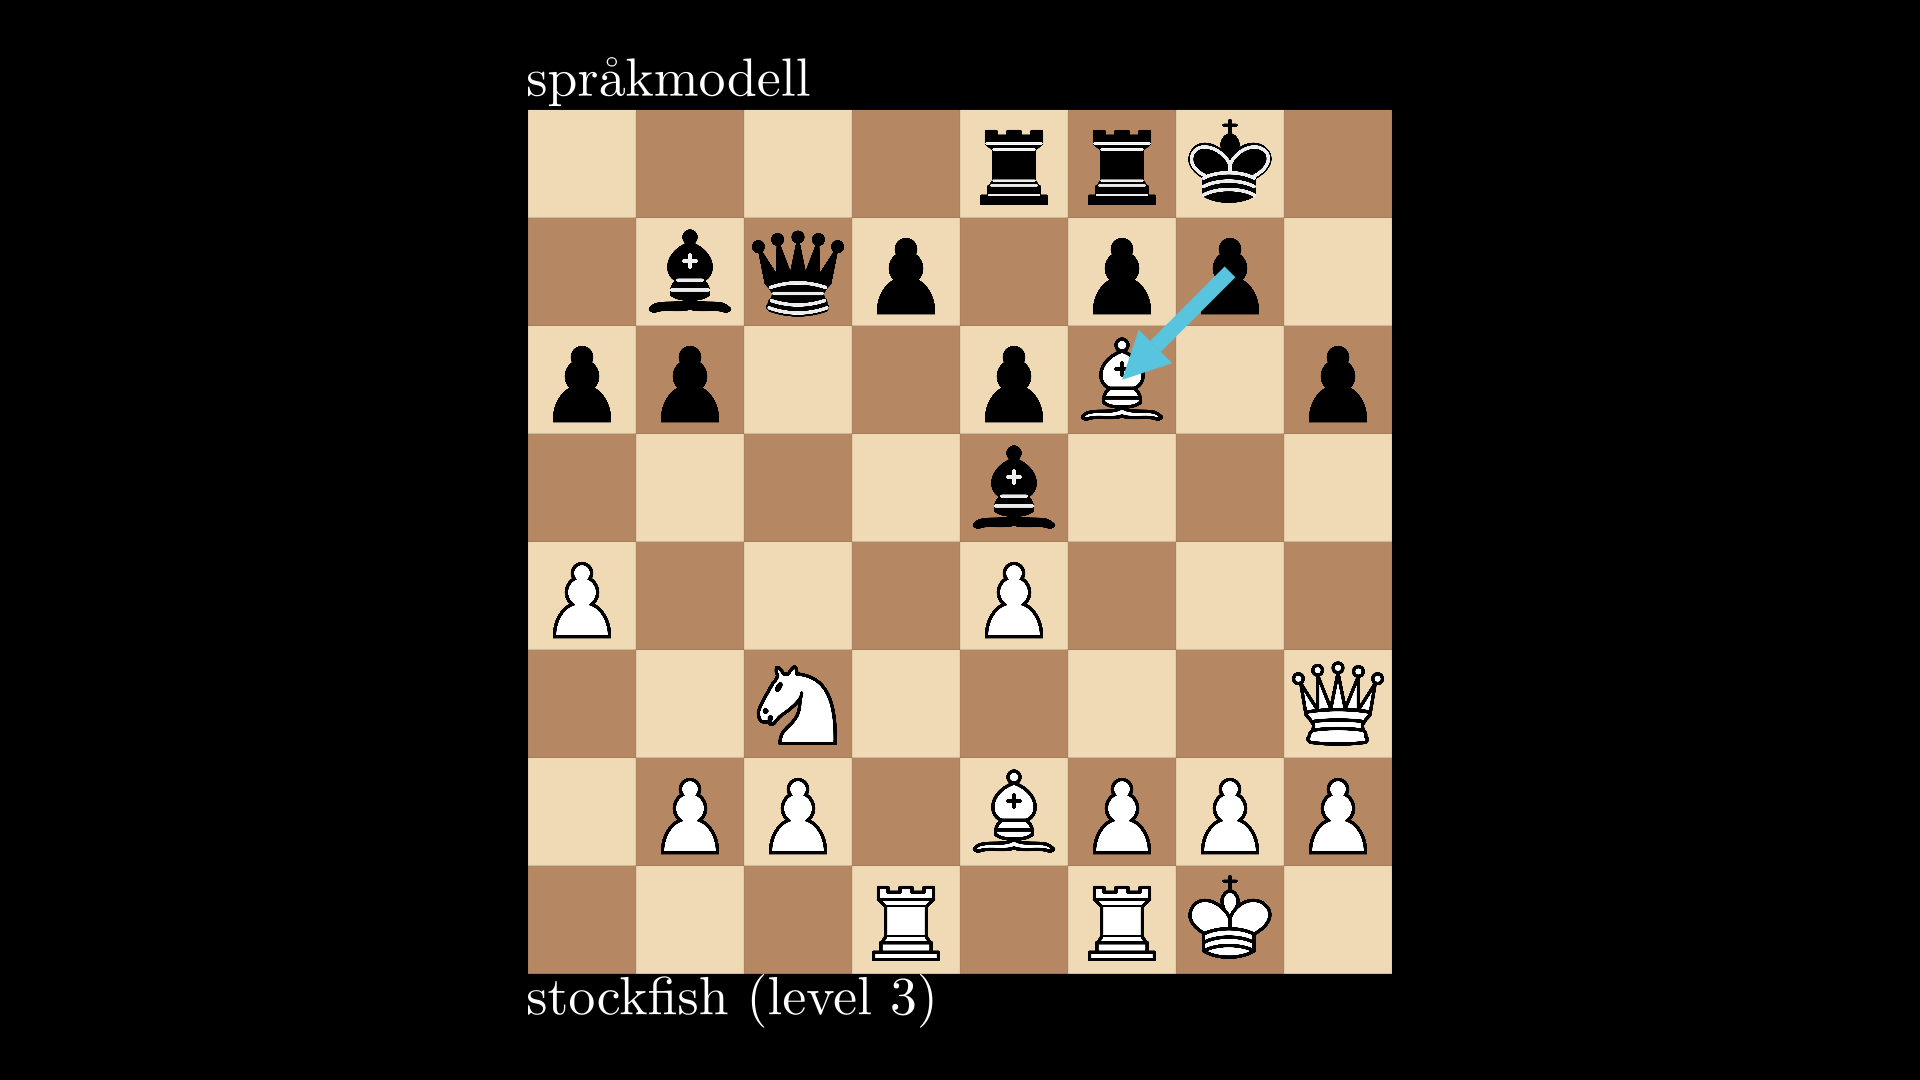
Dette er første bukken i spillet. Nå har vi nådd et vippepunkt, der det virker som at språkmodellen har "gått tom for gode trekk".
Grunnen til at gxf6 er et dårlig trekk er at det tillater hvit sin dronning å ta bonden på h3:
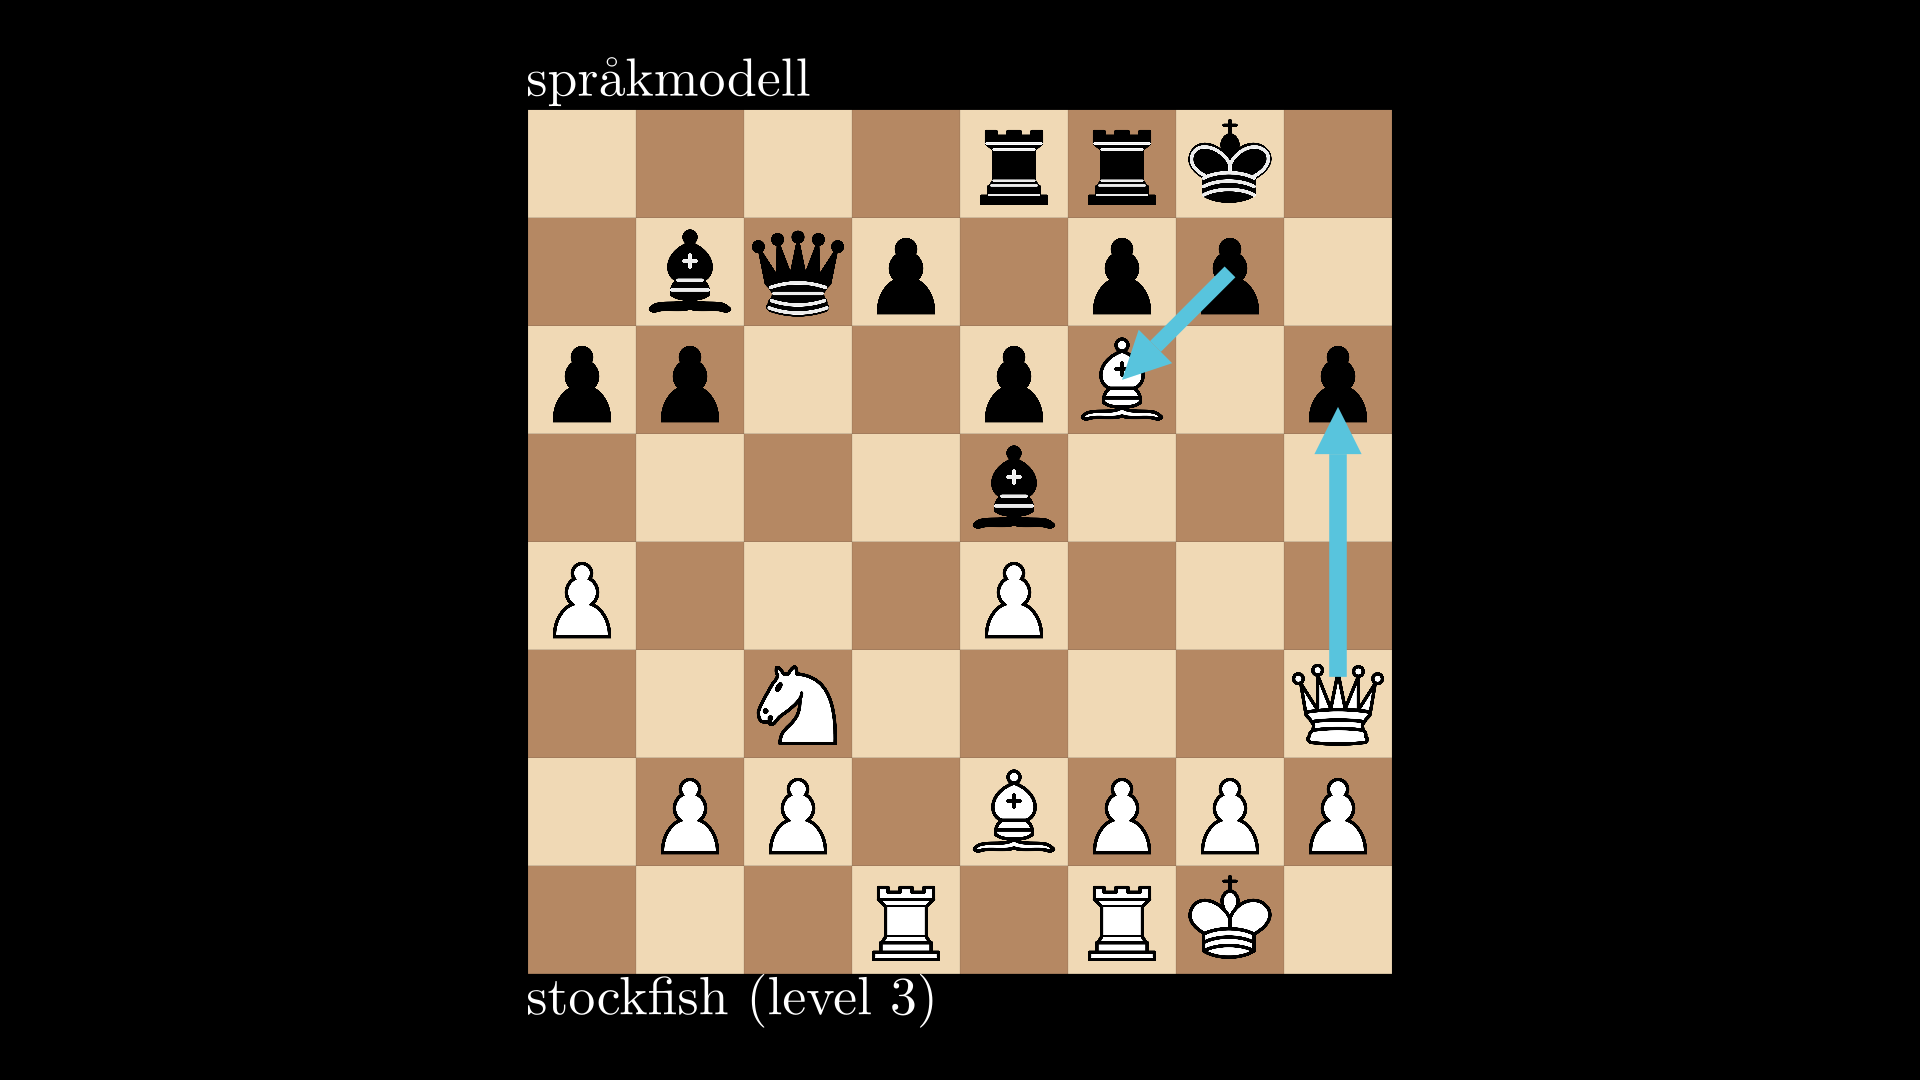
Og nå er kongen i en veldig dårlig posisjon.
Se hva som hadde skjedd hvis språkmodellen hadde spilt Bxf6
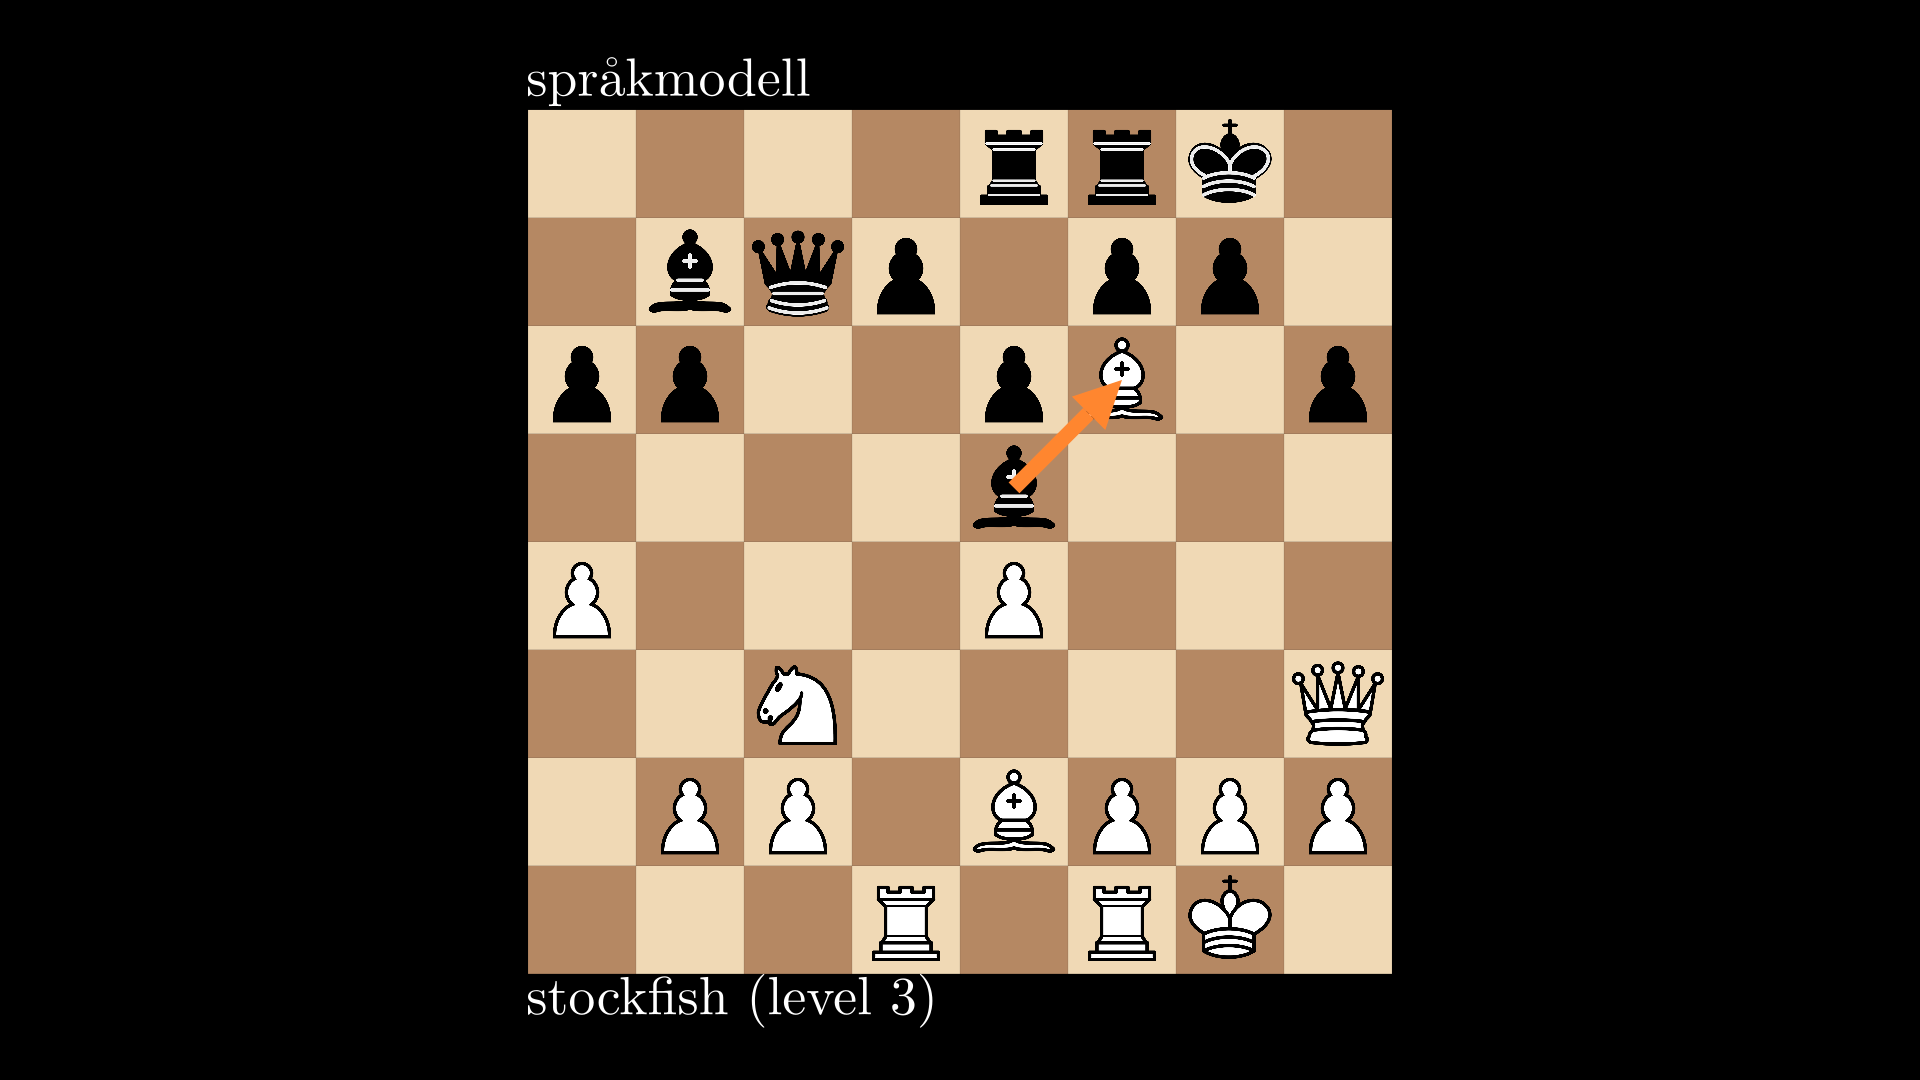
Dette trekket beholder forsvaret til kongen. Stockfish 18 forteller oss at språkmodellen hadde ledet med omtrent en hel bonde dersom den hadde spilt dette i stedet.
Språkmodellen spilte bukket og ligger under med omtrent 2,7 bønder.
Åpningen var lovende, språkmodellen spilte nøyaktig og holdt seg godt. Men etter åpningsfasen falt nøyaktigheten betydelig, og de fleste trekk i midtspillet og sluttspillet var langt fra optimale. Stockfish på nivå 3 er et relativt lavt nivå, og klarte ikke å utnytte tabben. Den spilte dronningen vekk i stedet for å ta bonden som var gratis. Likevel, fordi språkmodellen tilsynelatende hadde "gått tom for gode trekk", fortsatte den å forverre sin egen posisjon, og endte til slutt med å spille seg selv inn i sjakkmatt.
Bot vs stockfish på nivå 8
Stockfish nivå 8 er det høyeste nivået Lichess tilbyr, og forskjellen fra nivå 3 er betydelig. Modellen spiller som hvit.
Åpningen er gjenkjennelig, de første trekkene er presise og fornuftige, i tråd med det vi så mot nivå 3. Men Stockfish nivå 8 utnytter ethvert avvik umiddelbart, og etter åpningsfasen eskalerer situasjonen raskt. Partiet ender med sjakkmatt på trekk 13.
Chess.com sin analyse estimerer modellens spill til rundt 1150 Elo, selv om jeg er usikker på hvor nøyaktig dette målet er. Med tanke på at modellen er trent fra bunnen av på forholdsvis lite data er det et greit utgangspunkt.
Det er uansett et tydelig bilde på hvor smal modellens styrke er: innenfor velkjente åpningsstillinger er den imponerende, men mot en motstander som straffer hvert eneste avvik uten nåde holder den ikke lenge.
I etterkant
En kritisk tabbe
Se på denne sekvensen spilt av språkmodellen i partiet mot stockfish nivå 3:
I løpet av disse trekkene gir språkmodellen bort 30 poeng med materiale, dette kan man kalle selvdestruktive trekk. Det er en enorm kontrast mellom disse trekkene og nivået vi ser under åpningen. Så hvorfor har modellen blitt så dårlig på alt utenom åpninger?
Det er verdt å nevne at transformermodellen, på lik linje med de fleste moderne maskinlæringsarkitekturer, er en såkalt black box. Det vil si at når modellen først er trent, er det svært vanskelig å forstå nøyaktig hvorfor den tar de valgene den gjør. Man kan analysere treningsdataen og komme opp med teorier, men den enkleste måten å faktisk forstå atferden på er å teste den i praksis.
Modellen er trent på posisjoner fra både vinnende og tapende stillinger, i ettertid er det tydelig at modellen burde kun trent på stillinger til posisjoner som er vinnende, men dette tenkte jeg ikke på. I åpningen spiller selv tapende sider relativt bra (spesielt med tanke på at datasettet består av høyt rangerte spillere). I åpningen er det jevnt og begge parter gjør fornuftige trekk. Men etter hvert som spillet utvikler seg, oppstår det gjerne en klar vinner og en klar taper. Den tapende siden vil fra det punktet naturlig nok ha en god del dårlige trekk i treningsdataen. Siden modellen er trent på disse trekkene på lik linje med de gode, kan den ha lært mange dårlige vaner, og det er nettopp dette vi ser i praksis: så snart modellen havner i en presset stilling, forverrer den posisjonen sin ytterligere fremfor å forsvare seg.
Menneske eller AI?
Målet var aldri å slå Stockfish. Målet var å se om en språkmodell kunne lære seg det menneskelige blikket for sjakk, de fristende, naturlige trekkene som menneskelige spillere trekkes mot, snarere enn de kalde, kalkulative trekkene som kjennetegner tradisjonelle sjakkprogrammer.
Resultatet er blandet, men ikke uten potensial. I åpningen er modellen genuint imponerende, den spiller de mest populære trekkene med høy nøyaktighet, og holder seg på linje med de sterkeste menneskelige spillere gjør i åpningsfasen.
Utenfor åpningen, derimot, faller det fort fra hverandre. Modellen har tilsynelatende lært åpningsteori svært godt, men mangler evnen til å tenke selvstendig når den havner i ukjent terreng. Det er ikke overraskende i ettertid, treningsdataen inneholder like mange tapende stillinger som vinnende, og modellen har dermed også lært de dårlige vanene til den tapende siden.
Filtrer bort tapende stillinger fra treningsdataen, tren over flere epoker, og bytt til en decoder-arkitektur, og mye av svakheten i midtspillet forsvinner sannsynligvis. Kjernetanken holder fortsatt: en språkmodell som er trent på menneskelige partier vil naturlig lære menneskelige mønstre, ikke Stockfish sine.
Sjakk er et godt testbed for kunstig intelligens nettopp fordi reglene er absolutte, men spillet er uendelig komplekst.